Domain fl4.de kaufen?
Wir ziehen mit dem Projekt
fl4.de um.
Sind Sie am Kauf der Domain
fl4.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain fl4.de kaufen?
Will Klarna online banking data?
Klarna does not provide online banking services. It is a payment solutions provider that allows customers to make purchases online and pay later or in installments. Klarna may require certain personal and financial information to process payments, but it does not have access to or store online banking data. **
Warum blockiert G Data Internet Security mein Internet?
Es gibt verschiedene Gründe, warum G Data Internet Security Ihr Internet blockieren könnte. Es könnte sein, dass die Firewall-Einstellungen zu restriktiv sind und den Zugriff auf bestimmte Websites oder Dienste blockieren. Es könnte auch sein, dass die Software eine potenzielle Bedrohung erkannt hat und den Zugriff auf diese Website oder Dienst blockiert, um Ihre Sicherheit zu gewährleisten. Es ist ratsam, die Einstellungen der Software zu überprüfen und gegebenenfalls anzupassen oder den Kundensupport von G Data zu kontaktieren, um das Problem zu lösen. **
Ähnliche Suchbegriffe für Causal-Inference-for-Data
Top-Angebote
Produkte zum Begriff Causal-Inference-for-Data:
-
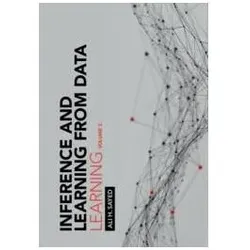
Inference and Learning from Data: Volume 3, Fachbücher von Ali H. SayedDas Buch "Inference and Learning from Data: Volume 3" bietet eine umfassende und tiefgehende Analyse von Methoden und Techniken im Bereich des maschinellen Lernens und der Datenanalyse. Es behandelt eine Vielzahl von Themen, die von klassischen Ansätzen wie der linearen Regression und Entscheidungsbäumen bis hin zu modernen Methoden wie tiefen neuronalen Netzwerken und generativen Modellen reichen. Die Inhalte sind strukturiert und klar gegliedert, was es sowohl für Studierende als auch für Fachleute in den Sozialwissenschaften zu einer wertvollen Ressource macht. Die behandelten Konzepte werden durch praktische Beispiele und theoretische Erklärungen ergänzt, um ein besseres Verständnis der Materie zu fördern. Dieses Buch ist ein unverzichtbares Nachschlagewerk für alle, die sich mit den Herausforderungen und Möglichkeiten des maschinellen Lernens auseinandersetzen möchten. - Umfassende Analyse von maschinellen Lernmethoden - Behandlung klassischer und moderner Techniken - Strukturierte und klare Gliederung der Inhalte - Praktische Beispiele zur Vertiefung des Verständnisses.119,77 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
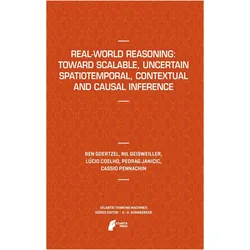
Real-World Reasoning: Toward Scalable, Uncertain Spatiotemporal, Contextual and Causal Inference, Fachbücher von Ben Goertzel, Nil Geisweiller, Cassio Pennachin, Lucio Coelho, Predrag JanicicDas Buch "Real-World Reasoning: Toward Scalable, Uncertain Spatiotemporal, Contextual and Causal Inference" bietet eine umfassende Analyse der Herausforderungen, die mit der Verarbeitung und Analyse komplexer Informationen aus der realen Welt verbunden sind. Es thematisiert die Schwierigkeiten, die bei der Nutzung grosser Datenmengen auftreten, und beleuchtet die limitierten Ansätze, die gegenwärtig zur Verfügung stehen, um diese Informationen sinnvoll zu nutzen. Die Autoren, darunter Predrag Janicic, Nil Geisweiller, Ben Goertzel, Lucio Coelho und Cassio Pennachin, präsentieren innovative Lösungen, insbesondere durch die Anwendung von probabilistic logic networks (PLN). Diese Methodik wird anhand praktischer Beispiele erläutert, die zeigen, wie realweltliches Denken in verschiedenen Kontexten angewendet werden kann. Das Buch richtet sich an Fachleute und Studierende im Bereich Technik und IT, die ein tieferes Verständnis für die Verarbeitung komplexer Daten und deren Anwendung in realen Szenarien erlangen möchten.128,30 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Red Hat AI Inference Server (Physical Node or Virtual Node)Red Hat AI Inference Server – Enterprise-Lösung für KI-Inferenz auf physischen oder virtuellen Nodes Eine professionelle Red Hat Subskription für Unternehmen, die Large-Language-Models und KI-Inferenz-Workloads kontrolliert in produktiven IT-Umgebungen bereitstellen möchten. Red Hat AI Inference Server (Physical Node or Virtual Node) ist eine Red Hat Lösung für Unternehmen, die KI-Inferenz-Workloads professionell betreiben möchten. Die Lösung richtet sich an IT-Organisationen, Plattformteams und Rechenzentren, die Modelle bereitstellen, Inferenzprozesse optimieren und KI-Anwendungen in vorhandene Infrastruktur-, Sicherheits- und Betriebsprozesse einbinden möchten. Wenn Sie diese Red Hat Lösung kaufen , erhalten Sie eine passende Subskription für den vorgesehenen Einsatzbereich. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Weitere passende Lösungen finden Sie in unserer Kategorie Red Hat kaufen . Diese Variante ist für den Einsatz auf einem Physical Node oder Virtual Node vorgesehen. Dadurch kann Red Hat AI Inference Server sowohl in geeigneten Serverumgebungen als auch in virtualisierten Infrastrukturen eingeordnet werden, sofern Hardware, Betriebssystem, Containerumgebung, AI-Beschleuniger und Red Hat Bedingungen zum geplanten Einsatz passen. Für moderne KI-Inferenz und LLM-Serving Red Hat AI Inference Server unterstützt Unternehmen beim Betrieb von Inferenzprozessen für Large-Language-Models und andere KI-nahe Anwendungsszenarien. Im Mittelpunkt steht die Bereitstellung von Modellen für produktive Anwendungen, interne Plattformdienste, Assistenzsysteme, Agentic-AI-Workflows oder Model-as-a-Service-Ansätze. Die Lösung eignet sich besonders für Organisationen, die KI nicht nur testen, sondern kontrolliert in professionelle IT-Umgebungen einbinden möchten. Dabei stehen Performance, Skalierbarkeit, betriebliche Kontrolle und eine saubere Integration in vorhandene Plattformprozesse im Vordergrund. Physical Node oder Virtual Node Diese Subskriptionsvariante ist für einen physischen oder virtuellen Node vorgesehen. Unternehmen können Red Hat AI Inference Server dadurch passend zu ihrer vorhandenen Infrastruktur planen, etwa auf geeigneter Server-Hardware, in virtualisierten Umgebungen oder innerhalb einer breiteren Red Hat Plattformstrategie. Vor dem Einsatz sollte geprüft werden, welche Systeme, Beschleuniger, Container-Runtimes, Modelle und Workloads vorgesehen sind. So lässt sich sicherstellen, dass technische Umgebung, Ressourcenplanung und Subskriptionsmodell sauber zusammenpassen. Für produktive KI-Workloads im Unternehmen KI-Inferenz stellt besondere Anforderungen an Plattform, Hardware, Modellbereitstellung, Sicherheit und Betrieb. Red Hat AI Inference Server unterstützt Unternehmen dabei, solche Workloads strukturierter zu betreiben und besser in vorhandene IT-Prozesse einzubinden. Die Lösung eignet sich für Organisationen, die generative KI, interne KI-Services oder modellbasierte Anwendungen produktiver und kontrollierter bereitstellen möchten. Optimiert für Inferenzprozesse Red Hat AI Inference Server ist auf den Betrieb von Inferenz-Workloads ausgerichtet. Dabei geht es nicht um das Training von Modellen, sondern um die effiziente Bereitstellung und Nutzung vorhandener Modelle in Anwendungen und Plattformdiensten. Unternehmen können diese Lösung einsetzen, um KI-Funktionen für interne Anwendungen, Chatbots, Assistenzsysteme, Analyseprozesse oder weitere geschäftsbezogene Szenarien bereitzustellen. Die genaue technische Umsetzung hängt von Modell, Hardware, Plattform und Sicherheitsanforderungen ab. Einbindung in Hybrid-Cloud- und Plattformstrategien Red Hat AI Inference Server kann Teil einer modernen Hybrid-Cloud-Strategie sein, bei der KI-Workloads nicht isoliert betrieben werden, sondern in vorhandene Plattform-, Sicherheits- und Betriebsmodelle eingebunden sind. Das ist besonders relevant für Unternehmen, die KI-Inferenz über unterschiedliche Infrastrukturmodelle hinweg planen und dabei auf einheitliche Betriebsprozesse, technische Kontrolle und nachvollziehbare Skalierung achten möchten. Für AI-Beschleuniger und geeignete Serverumgebungen KI-Inferenz profitiert häufig von geeigneten AI-Beschleunigern und einer passenden Systemarchitektur. Deshalb sollte vor der Bestellung geprüft werden, welche Hardware, Treiber, Containerumgebung und Modellanforderungen in der geplanten Umgebung vorhanden sind. Die Lösung sollte immer im Zusammenhang mit der konkreten Infrastruktur betrachtet werden. Besonders bei produktiven KI-Diensten empfiehlt sich eine saubere Prüfung der unterstützten Plattformen, der eingesetzten Beschleuniger und der betrieblichen Anforderungen. Mehr Struktur für KI-Plattformteams In größeren Organisationen wird KI-Inferenz häufig von Plattformteams bereitgestellt, damit Fachbereiche, Entwicklerteams oder interne Anwendungen Modelle kontrolliert nutzen können. Red Hat AI Inference Server kann dabei helfen, solche Bereitstel...1571,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kaspersky Threat Data Feeds - Ransomware URLKaspersky Threat Data Feeds – Ransomware URL In der heutigen digitalen Landschaft stellen Ransomware-Angriffe eine der gravierendsten Bedrohungen für Unternehmen und Organisationen dar. Angreifer nutzen zunehmend raffinierte Methoden, um Systeme zu infiltrieren und Daten zu verschlüsseln, was zu erheblichen finanziellen Verlusten und Reputationsschäden führen kann. Um diesen Gefahren effektiv zu begegnen, bietet Kaspersky mit den **Threat Data Feeds – Ransomware URL** eine spezialisierte Lösung, die Unternehmen dabei unterstützt, potenziell schädliche Webressourcen frühzeitig zu identifizieren und entsprechende Schutzmaßnahmen zu ergreifen. Überblick über Kaspersky Threat Data Feeds – Ransomware URL Die **Kaspersky Threat Data Feeds – Ransomware URL** liefern kontinuierlich aktualisierte Informationen über URLs, Domains und Hosts, die mit Ransomware in Verbindung stehen. Diese Datenfeeds ermöglichen es Unternehmen, ihre Sicherheitsinfrastrukturen proaktiv zu stärken, indem sie potenziell gefährliche Webressourcen identifizieren und blockieren, bevor sie Schaden anrichten können. :contentReference[oaicite:0]{index=0} Hauptfunktionen Umfassende Bedrohungsdaten: Bereitstellung von URLs, Domains und Hosts, die mit Ransomware-Aktivitäten in Verbindung stehen. Regelmäßige Aktualisierung: Ständige Aktualisierung der Datenfeeds, um den neuesten Bedrohungen gerecht zu werden. Integration in Sicherheitslösungen: Einfache Integration in bestehende Sicherheitsinfrastrukturen wie SIEM-Systeme, Firewalls und Web-Gateways. Kontextuelle Informationen: Zusätzliche Details zu jeder Bedrohung, einschließlich Bedrohungsname, Zeitstempel und Geolokalisierung. Reduzierung von Fehlalarmen: Durch präzise Daten werden Fehlalarme minimiert und die Effizienz des Sicherheitsteams erhöht. Vorteile für Ihr Unternehmen Erhöhter Schutz: Frühzeitige Erkennung und Abwehr von Ransomware-Bedrohungen durch Identifizierung schädlicher Webressourcen. Proaktive Sicherheitsmaßnahmen: Möglichkeit, Sicherheitsrichtlinien basierend auf aktuellen Bedrohungsdaten anzupassen. Effiziente Ressourcenallokation: Reduzierung des Aufwands für die manuelle Bedrohungserkennung und -analyse. Compliance-Unterstützung: Hilfe bei der Einhaltung branchenspezifischer Sicherheitsstandards und -vorschriften. Skalierbarkeit: Anpassbar an die spezifischen Anforderungen von Unternehmen jeder Größe. Integration und Kompatibilität Die **Kaspersky Threat Data Feeds – Ransomware URL** sind so konzipiert, dass sie nahtlos in bestehende Sicherheitsinfrastrukturen integriert werden können. Sie unterstützen gängige Datenformate wie JSON, OpenIoC, CSV und STIX, was die Integration in SIEM-Systeme, SOAR-Plattformen und andere Sicherheitslösungen erleichtert. Durch die Bereitstellung von APIs und Konnektoren wird der Integrationsprozess weiter vereinfacht26655,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Verursacht G Data Probleme mit dem Internet?
Es gibt keine allgemeine Aussage darüber, ob G Data Probleme mit dem Internet verursacht. Es kann jedoch vorkommen, dass bestimmte Einstellungen oder Konfigurationen von G Data zu Konflikten mit bestimmten Internetanwendungen führen können. In solchen Fällen ist es ratsam, die Einstellungen von G Data zu überprüfen oder den Kundendienst von G Data um Unterstützung zu bitten. **
-
Was bedeuten Data Science und Data Engineering?
Data Science bezieht sich auf die Analyse und Interpretation von Daten, um Erkenntnisse und Muster zu gewinnen, die bei der Lösung von Problemen und der Unterstützung von Entscheidungsprozessen helfen. Data Engineering hingegen bezieht sich auf die Entwicklung und Verwaltung von Dateninfrastrukturen, um sicherzustellen, dass Daten effizient erfasst, gespeichert, verarbeitet und analysiert werden können. Data Engineering legt den Fokus auf die technische Seite der Datenverarbeitung, während Data Science sich auf die Analyse und Interpretation der Daten konzentriert. **
-
Kann man mit Wirtschaftsinformatik Data Scientist oder Data Analyst werden?
Ja, mit einem Studium der Wirtschaftsinformatik kann man sowohl Data Scientist als auch Data Analyst werden. Wirtschaftsinformatik vermittelt Kenntnisse in den Bereichen Informatik und Betriebswirtschaft, die für diese Berufe relevant sind. Zusätzliche Weiterbildungen oder Spezialisierungen in den Bereichen Data Science oder Data Analytics können jedoch von Vorteil sein. **
-
Welche Förderungsmaßnahme gibt es für Data Analysts bzw. Data Scientists?
Es gibt verschiedene Förderungsmaßnahmen für Data Analysts und Data Scientists, je nach Land und Organisation. Zum Beispiel bieten Universitäten und Forschungseinrichtungen Stipendien und Forschungsprojekte an. Unternehmen können auch Weiterbildungsprogramme und Schulungen für ihre Mitarbeiter anbieten. Darüber hinaus gibt es auch staatliche Förderprogramme und Stipendien für Studierende und Forscher in diesem Bereich. **


Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
Sind "data" und "data" beim USB-Kabel TX und RX?
Nein, "data" und "data" beziehen sich nicht auf die TX (Transmit) und RX (Receive) Pins beim USB-Kabel. Beim USB-Kabel gibt es vier Pins: VCC (Stromversorgung), GND (Masse), D+ (Datenleitung) und D- (Datenleitung). Die TX- und RX-Pins werden normalerweise bei seriellen Kommunikationsschnittstellen wie UART verwendet. **
Top-Angebote
Produkte zum Begriff Causal-Inference-for-Data:
-
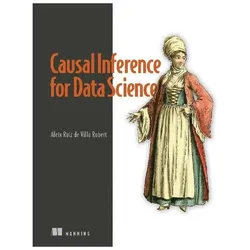
Causal Inference for Data Science, Fachbücher von David Sweet, Alex Ruiz de VillaWenn Sie die Ursache eines Ereignisses kennen, können Sie dessen Ergebnis beeinflussen. Diese zugängliche Einführung in die kausale Inferenz zeigt Ihnen, wie Sie Kausalität bestimmen und Effekte mithilfe von Statistik und maschinellem Lernen schätzen können. In "Kausale Inferenz für Data Science" lernen Sie, wie Sie: die Realität mit kausalen Grafiken modellieren, kausale Effekte mit statistischen und maschinellen Lerntechniken schätzen, entscheiden, wann A/B-Tests, kausale Inferenz und maschinelles Lernen eingesetzt werden sollten, Ziele, Annahmen, Risiken und Einschränkungen erklären und bewerten sowie feststellen, ob Sie genügend Variablen für Ihre Analyse haben. Es ist möglich, Ereignisse vorherzusagen, ohne zu wissen, was sie verursacht. Das Verständnis von Kausalität ermöglicht es Ihnen, datengestützte Vorhersagen zu treffen und auch einzugreifen, um die Ergebnisse zu beeinflussen. "Kausale Inferenz für Data Science" zeigt Ihnen, wie Sie Werkzeuge für Data Science entwickeln, die die Ursache von Trends und Ereignissen identifizieren können. Sie lernen, wie Sie historische Daten interpretieren, das Verhalten von Kunden verstehen und das Management befähigen, optimale Entscheidungen zu treffen.70,30 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
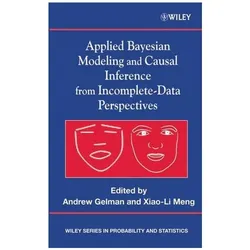
Applied Bayesian Modeling and Causal Inference from Incomplete-Data Perspectives, Sachbücher von Andrew Gelman, Xiao-Li MengVersammelt eine Sammlung von Artikeln über statistische Methoden zur Analyse fehlender Daten, einschliesslich multipler Imputation, Propensity Scores, Instrumentvariablen und bayesianischer Inferenz. Dieses Buch behandelt Forschungsthemen und praxisnahe Beispiele.169,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Inference and Learning from Data: Volume 3, Fachbücher von Ali H. SayedDas Buch "Inference and Learning from Data: Volume 3" bietet eine umfassende und tiefgehende Analyse von Methoden und Techniken im Bereich des maschinellen Lernens und der Datenanalyse. Es behandelt eine Vielzahl von Themen, die von klassischen Ansätzen wie der linearen Regression und Entscheidungsbäumen bis hin zu modernen Methoden wie tiefen neuronalen Netzwerken und generativen Modellen reichen. Die Inhalte sind strukturiert und klar gegliedert, was es sowohl für Studierende als auch für Fachleute in den Sozialwissenschaften zu einer wertvollen Ressource macht. Die behandelten Konzepte werden durch praktische Beispiele und theoretische Erklärungen ergänzt, um ein besseres Verständnis der Materie zu fördern. Dieses Buch ist ein unverzichtbares Nachschlagewerk für alle, die sich mit den Herausforderungen und Möglichkeiten des maschinellen Lernens auseinandersetzen möchten. - Umfassende Analyse von maschinellen Lernmethoden - Behandlung klassischer und moderner Techniken - Strukturierte und klare Gliederung der Inhalte - Praktische Beispiele zur Vertiefung des Verständnisses.119,77 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Real-World Reasoning: Toward Scalable, Uncertain Spatiotemporal, Contextual and Causal Inference, Fachbücher von Ben Goertzel, Nil Geisweiller, Cassio Pennachin, Lucio Coelho, Predrag JanicicDas Buch "Real-World Reasoning: Toward Scalable, Uncertain Spatiotemporal, Contextual and Causal Inference" bietet eine umfassende Analyse der Herausforderungen, die mit der Verarbeitung und Analyse komplexer Informationen aus der realen Welt verbunden sind. Es thematisiert die Schwierigkeiten, die bei der Nutzung grosser Datenmengen auftreten, und beleuchtet die limitierten Ansätze, die gegenwärtig zur Verfügung stehen, um diese Informationen sinnvoll zu nutzen. Die Autoren, darunter Predrag Janicic, Nil Geisweiller, Ben Goertzel, Lucio Coelho und Cassio Pennachin, präsentieren innovative Lösungen, insbesondere durch die Anwendung von probabilistic logic networks (PLN). Diese Methodik wird anhand praktischer Beispiele erläutert, die zeigen, wie realweltliches Denken in verschiedenen Kontexten angewendet werden kann. Das Buch richtet sich an Fachleute und Studierende im Bereich Technik und IT, die ein tieferes Verständnis für die Verarbeitung komplexer Daten und deren Anwendung in realen Szenarien erlangen möchten.128,30 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Will Klarna online banking data?
Klarna does not provide online banking services. It is a payment solutions provider that allows customers to make purchases online and pay later or in installments. Klarna may require certain personal and financial information to process payments, but it does not have access to or store online banking data. **
-
Warum blockiert G Data Internet Security mein Internet?
Es gibt verschiedene Gründe, warum G Data Internet Security Ihr Internet blockieren könnte. Es könnte sein, dass die Firewall-Einstellungen zu restriktiv sind und den Zugriff auf bestimmte Websites oder Dienste blockieren. Es könnte auch sein, dass die Software eine potenzielle Bedrohung erkannt hat und den Zugriff auf diese Website oder Dienst blockiert, um Ihre Sicherheit zu gewährleisten. Es ist ratsam, die Einstellungen der Software zu überprüfen und gegebenenfalls anzupassen oder den Kundensupport von G Data zu kontaktieren, um das Problem zu lösen. **
-
Verursacht G Data Probleme mit dem Internet?
Es gibt keine allgemeine Aussage darüber, ob G Data Probleme mit dem Internet verursacht. Es kann jedoch vorkommen, dass bestimmte Einstellungen oder Konfigurationen von G Data zu Konflikten mit bestimmten Internetanwendungen führen können. In solchen Fällen ist es ratsam, die Einstellungen von G Data zu überprüfen oder den Kundendienst von G Data um Unterstützung zu bitten. **
-
Was bedeuten Data Science und Data Engineering?
Data Science bezieht sich auf die Analyse und Interpretation von Daten, um Erkenntnisse und Muster zu gewinnen, die bei der Lösung von Problemen und der Unterstützung von Entscheidungsprozessen helfen. Data Engineering hingegen bezieht sich auf die Entwicklung und Verwaltung von Dateninfrastrukturen, um sicherzustellen, dass Daten effizient erfasst, gespeichert, verarbeitet und analysiert werden können. Data Engineering legt den Fokus auf die technische Seite der Datenverarbeitung, während Data Science sich auf die Analyse und Interpretation der Daten konzentriert. **
Ähnliche Suchbegriffe für Causal-Inference-for-Data
-
Red Hat AI Inference Server (Physical Node or Virtual Node)Red Hat AI Inference Server – Enterprise-Lösung für KI-Inferenz auf physischen oder virtuellen Nodes Eine professionelle Red Hat Subskription für Unternehmen, die Large-Language-Models und KI-Inferenz-Workloads kontrolliert in produktiven IT-Umgebungen bereitstellen möchten. Red Hat AI Inference Server (Physical Node or Virtual Node) ist eine Red Hat Lösung für Unternehmen, die KI-Inferenz-Workloads professionell betreiben möchten. Die Lösung richtet sich an IT-Organisationen, Plattformteams und Rechenzentren, die Modelle bereitstellen, Inferenzprozesse optimieren und KI-Anwendungen in vorhandene Infrastruktur-, Sicherheits- und Betriebsprozesse einbinden möchten. Wenn Sie diese Red Hat Lösung kaufen , erhalten Sie eine passende Subskription für den vorgesehenen Einsatzbereich. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Weitere passende Lösungen finden Sie in unserer Kategorie Red Hat kaufen . Diese Variante ist für den Einsatz auf einem Physical Node oder Virtual Node vorgesehen. Dadurch kann Red Hat AI Inference Server sowohl in geeigneten Serverumgebungen als auch in virtualisierten Infrastrukturen eingeordnet werden, sofern Hardware, Betriebssystem, Containerumgebung, AI-Beschleuniger und Red Hat Bedingungen zum geplanten Einsatz passen. Für moderne KI-Inferenz und LLM-Serving Red Hat AI Inference Server unterstützt Unternehmen beim Betrieb von Inferenzprozessen für Large-Language-Models und andere KI-nahe Anwendungsszenarien. Im Mittelpunkt steht die Bereitstellung von Modellen für produktive Anwendungen, interne Plattformdienste, Assistenzsysteme, Agentic-AI-Workflows oder Model-as-a-Service-Ansätze. Die Lösung eignet sich besonders für Organisationen, die KI nicht nur testen, sondern kontrolliert in professionelle IT-Umgebungen einbinden möchten. Dabei stehen Performance, Skalierbarkeit, betriebliche Kontrolle und eine saubere Integration in vorhandene Plattformprozesse im Vordergrund. Physical Node oder Virtual Node Diese Subskriptionsvariante ist für einen physischen oder virtuellen Node vorgesehen. Unternehmen können Red Hat AI Inference Server dadurch passend zu ihrer vorhandenen Infrastruktur planen, etwa auf geeigneter Server-Hardware, in virtualisierten Umgebungen oder innerhalb einer breiteren Red Hat Plattformstrategie. Vor dem Einsatz sollte geprüft werden, welche Systeme, Beschleuniger, Container-Runtimes, Modelle und Workloads vorgesehen sind. So lässt sich sicherstellen, dass technische Umgebung, Ressourcenplanung und Subskriptionsmodell sauber zusammenpassen. Für produktive KI-Workloads im Unternehmen KI-Inferenz stellt besondere Anforderungen an Plattform, Hardware, Modellbereitstellung, Sicherheit und Betrieb. Red Hat AI Inference Server unterstützt Unternehmen dabei, solche Workloads strukturierter zu betreiben und besser in vorhandene IT-Prozesse einzubinden. Die Lösung eignet sich für Organisationen, die generative KI, interne KI-Services oder modellbasierte Anwendungen produktiver und kontrollierter bereitstellen möchten. Optimiert für Inferenzprozesse Red Hat AI Inference Server ist auf den Betrieb von Inferenz-Workloads ausgerichtet. Dabei geht es nicht um das Training von Modellen, sondern um die effiziente Bereitstellung und Nutzung vorhandener Modelle in Anwendungen und Plattformdiensten. Unternehmen können diese Lösung einsetzen, um KI-Funktionen für interne Anwendungen, Chatbots, Assistenzsysteme, Analyseprozesse oder weitere geschäftsbezogene Szenarien bereitzustellen. Die genaue technische Umsetzung hängt von Modell, Hardware, Plattform und Sicherheitsanforderungen ab. Einbindung in Hybrid-Cloud- und Plattformstrategien Red Hat AI Inference Server kann Teil einer modernen Hybrid-Cloud-Strategie sein, bei der KI-Workloads nicht isoliert betrieben werden, sondern in vorhandene Plattform-, Sicherheits- und Betriebsmodelle eingebunden sind. Das ist besonders relevant für Unternehmen, die KI-Inferenz über unterschiedliche Infrastrukturmodelle hinweg planen und dabei auf einheitliche Betriebsprozesse, technische Kontrolle und nachvollziehbare Skalierung achten möchten. Für AI-Beschleuniger und geeignete Serverumgebungen KI-Inferenz profitiert häufig von geeigneten AI-Beschleunigern und einer passenden Systemarchitektur. Deshalb sollte vor der Bestellung geprüft werden, welche Hardware, Treiber, Containerumgebung und Modellanforderungen in der geplanten Umgebung vorhanden sind. Die Lösung sollte immer im Zusammenhang mit der konkreten Infrastruktur betrachtet werden. Besonders bei produktiven KI-Diensten empfiehlt sich eine saubere Prüfung der unterstützten Plattformen, der eingesetzten Beschleuniger und der betrieblichen Anforderungen. Mehr Struktur für KI-Plattformteams In größeren Organisationen wird KI-Inferenz häufig von Plattformteams bereitgestellt, damit Fachbereiche, Entwicklerteams oder interne Anwendungen Modelle kontrolliert nutzen können. Red Hat AI Inference Server kann dabei helfen, solche Bereitstel...1571,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kaspersky Threat Data Feeds - Ransomware URLKaspersky Threat Data Feeds – Ransomware URL In der heutigen digitalen Landschaft stellen Ransomware-Angriffe eine der gravierendsten Bedrohungen für Unternehmen und Organisationen dar. Angreifer nutzen zunehmend raffinierte Methoden, um Systeme zu infiltrieren und Daten zu verschlüsseln, was zu erheblichen finanziellen Verlusten und Reputationsschäden führen kann. Um diesen Gefahren effektiv zu begegnen, bietet Kaspersky mit den **Threat Data Feeds – Ransomware URL** eine spezialisierte Lösung, die Unternehmen dabei unterstützt, potenziell schädliche Webressourcen frühzeitig zu identifizieren und entsprechende Schutzmaßnahmen zu ergreifen. Überblick über Kaspersky Threat Data Feeds – Ransomware URL Die **Kaspersky Threat Data Feeds – Ransomware URL** liefern kontinuierlich aktualisierte Informationen über URLs, Domains und Hosts, die mit Ransomware in Verbindung stehen. Diese Datenfeeds ermöglichen es Unternehmen, ihre Sicherheitsinfrastrukturen proaktiv zu stärken, indem sie potenziell gefährliche Webressourcen identifizieren und blockieren, bevor sie Schaden anrichten können. :contentReference[oaicite:0]{index=0} Hauptfunktionen Umfassende Bedrohungsdaten: Bereitstellung von URLs, Domains und Hosts, die mit Ransomware-Aktivitäten in Verbindung stehen. Regelmäßige Aktualisierung: Ständige Aktualisierung der Datenfeeds, um den neuesten Bedrohungen gerecht zu werden. Integration in Sicherheitslösungen: Einfache Integration in bestehende Sicherheitsinfrastrukturen wie SIEM-Systeme, Firewalls und Web-Gateways. Kontextuelle Informationen: Zusätzliche Details zu jeder Bedrohung, einschließlich Bedrohungsname, Zeitstempel und Geolokalisierung. Reduzierung von Fehlalarmen: Durch präzise Daten werden Fehlalarme minimiert und die Effizienz des Sicherheitsteams erhöht. Vorteile für Ihr Unternehmen Erhöhter Schutz: Frühzeitige Erkennung und Abwehr von Ransomware-Bedrohungen durch Identifizierung schädlicher Webressourcen. Proaktive Sicherheitsmaßnahmen: Möglichkeit, Sicherheitsrichtlinien basierend auf aktuellen Bedrohungsdaten anzupassen. Effiziente Ressourcenallokation: Reduzierung des Aufwands für die manuelle Bedrohungserkennung und -analyse. Compliance-Unterstützung: Hilfe bei der Einhaltung branchenspezifischer Sicherheitsstandards und -vorschriften. Skalierbarkeit: Anpassbar an die spezifischen Anforderungen von Unternehmen jeder Größe. Integration und Kompatibilität Die **Kaspersky Threat Data Feeds – Ransomware URL** sind so konzipiert, dass sie nahtlos in bestehende Sicherheitsinfrastrukturen integriert werden können. Sie unterstützen gängige Datenformate wie JSON, OpenIoC, CSV und STIX, was die Integration in SIEM-Systeme, SOAR-Plattformen und andere Sicherheitslösungen erleichtert. Durch die Bereitstellung von APIs und Konnektoren wird der Integrationsprozess weiter vereinfacht26655,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kaspersky Threat Data Feeds - Malicious URLKaspersky Threat Data Feeds – Malicious URL In einer zunehmend vernetzten Welt sind Bedrohungen durch schädliche URLs eine der größten Herausforderungen für Unternehmen, die ihre Netzwerksicherheit gewährleisten möchten. Schädliche URLs werden von Cyberkriminellen genutzt, um Phishing-Angriffe, Malware-Infektionen und andere bösartige Aktivitäten zu initiieren, die die Datensicherheit und Vertraulichkeit beeinträchtigen können. Mit **Kaspersky Threat Data Feeds – Malicious URL** erhalten Unternehmen Zugang zu einer stets aktuellen und umfassenden Datenbank mit potenziell gefährlichen URLs, die dabei hilft, solche Bedrohungen proaktiv zu erkennen und abzuwehren. Überblick über Kaspersky Threat Data Feeds – Malicious URL Der **Kaspersky Threat Data Feeds – Malicious URL**-Dienst stellt eine kontinuierlich aktualisierte Liste von URLs bereit, die in Verbindung mit schädlichen Aktivitäten stehen. Diese Daten können Unternehmen dabei unterstützen, ihre Sicherheitsmaßnahmen zu verstärken, indem sie sicherstellen, dass bösartige URLs erkannt und blockiert werden, bevor sie Schaden anrichten können. Die Datenfeeds umfassen Informationen über URLs, die für Phishing, Malware-Verbreitung, C&C-Server (Command and Control) und andere Bedrohungen bekannt sind. Die Daten werden von Kasperskys weltweitem Team von Cybersicherheitsexperten gesammelt und analysiert, um eine hohe Präzision und Relevanz sicherzustellen. Hauptfunktionen Umfassende Sammlung bösartiger URLs: Kontinuierliche Bereitstellung einer umfangreichen Datenbank schädlicher URLs, die regelmäßig aktualisiert wird. Präzise Bedrohungsinformationen: Jeder Eintrag wird durch zusätzliche Informationen ergänzt, wie z. B. Bedrohungstyp und Verbreitungsmuster. Nahtlose Integration: Einfache Integration der Daten in bestehende SIEM-Systeme, Firewalls, Web-Gateways und andere Sicherheitslösungen. Minimierung von Fehlalarmen: Durch die Bereitstellung spezifischer Bedrohungsdaten werden Fehlalarme reduziert und die Effizienz des Sicherheitsteams erhöht. Erkennung und Blockierung in Echtzeit: Proaktive Abwehrmaßnahmen gegen Bedrohungen, bevor diese Schaden anrichten können. Vorteile für Ihr Unternehmen Erhöhter Schutz vor Bedrohungen: Durch den Zugang zu aktuellen und präzisen Bedrohungsdaten können Unternehmen schädliche URLs frühzeitig erkennen und blockieren. Optimierte Sicherheitsstrategie: Die Nutzung aktueller Bedrohungsdaten unterstützt die Entwicklung proaktiver Sicherheitsmaßnahmen und die Minimierung potenzieller Angriffspunkte. Effizienzsteigerung: Durch die Reduzierung von Fehlalarmen können sich Sicherheitsteams auf tatsächliche Bedrohungen konzentrieren und schneller reagieren. Compliance und Sicherheitsstandards: Unterstützung bei der Einhaltung gesetzlicher und branchenspezifischer Sicherheitsanforderungen durch effektive Bedrohungserkennung. Skalierbare Lösung: Geeignet für Unternehmen jeder Größe und anpassbar an spezifische Sicherheitsanforderungen und -infrastrukturen. Integration und Kompatibilität Die Kaspersky Threat Data Feeds – Malicious URL sind so konzipiert, dass sie problemlos in bestehende IT-Sicherheitsinfrastrukturen integriert werden können. Sie unterstützen verschiedene Formate wie JSON, CSV und STIX, was die Implementierung in SIEM-Systeme, SOAR-Plattformen und andere Sicherheitslösungen erleichtert. Mit der flexiblen API-Integration können Unternehmen die Bedrohungsdaten genau an ihre Bedürfnisse anpassen und nahtlos in ihre Sicherheitsarchitekturen integrieren. Anwendungsfälle für Kaspersky Threat Data Feeds – Malicious URL Schutz vor Phishing-Angriffen: Identifizierung und Blockierung bekannter Phishing-Websites, um die Sicherheit der Benutzer zu gewährleisten. Verhinderung von Malware-Infektionen: Früherkennung von URLs, die für die Verbreitung von Malware bekannt sind, um Infektionen zu verhindern. Abwehr von C&C-Kommunikation: Blockiert die Kommunikation zwischen bösartiger Software und C&C-Servern und reduziert so das Risiko von Datendiebstahl und Netzwerkübernahme.21324,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Cunningham, Scott: Causal Inference: The MixtapeCausal Inference: The Mixtape , The Mixtape , > , Erscheinungsjahr: 20210126, Produktform: Kartoniert, Autoren: Cunningham, Scott, Seitenzahl/Blattzahl: 584, Abbildungen: 91 b-w illus., Themenüberschrift: BUSINESS & ECONOMICS / Econometrics~MATHEMATICS / Applied~MATHEMATICS / Probability & Statistics / General, Fachschema: Englische Bücher / Wirtschaft, Business~Ökonometrie~Statistik / Wirtschaftsstatistik~Wirtschaftsstatistik~Algebra~Wahrscheinlichkeitsrechnung~Mathematik, Fachkategorie: Algebra~Wahrscheinlichkeitsrechnung und Statistik~Angewandte Mathematik, Warengruppe: TB/Wirtschaft/Allgemeines, Lexika, Geschichte, Fachkategorie: Ökonometrie und Wirtschaftsstatistik, Text Sprache: eng, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Yale University Press, Verlag: Yale University Press, Länge: 214, Breite: 140, Höhe: 48, Gewicht: 600, Produktform: Kartoniert, Genre: Importe, Genre: Importe, Katalog: LIB_ENBOOK, Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: internationale Titel, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0035, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,34,45 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kann man mit Wirtschaftsinformatik Data Scientist oder Data Analyst werden?
Ja, mit einem Studium der Wirtschaftsinformatik kann man sowohl Data Scientist als auch Data Analyst werden. Wirtschaftsinformatik vermittelt Kenntnisse in den Bereichen Informatik und Betriebswirtschaft, die für diese Berufe relevant sind. Zusätzliche Weiterbildungen oder Spezialisierungen in den Bereichen Data Science oder Data Analytics können jedoch von Vorteil sein. **
-
Welche Förderungsmaßnahme gibt es für Data Analysts bzw. Data Scientists?
Es gibt verschiedene Förderungsmaßnahmen für Data Analysts und Data Scientists, je nach Land und Organisation. Zum Beispiel bieten Universitäten und Forschungseinrichtungen Stipendien und Forschungsprojekte an. Unternehmen können auch Weiterbildungsprogramme und Schulungen für ihre Mitarbeiter anbieten. Darüber hinaus gibt es auch staatliche Förderprogramme und Stipendien für Studierende und Forscher in diesem Bereich. **
-
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
-
Sind "data" und "data" beim USB-Kabel TX und RX?
Nein, "data" und "data" beziehen sich nicht auf die TX (Transmit) und RX (Receive) Pins beim USB-Kabel. Beim USB-Kabel gibt es vier Pins: VCC (Stromversorgung), GND (Masse), D+ (Datenleitung) und D- (Datenleitung). Die TX- und RX-Pins werden normalerweise bei seriellen Kommunikationsschnittstellen wie UART verwendet. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.